En el post de quality dejé una lista de señales que Google guarda a nivel de site. Dos de ellas se me quedaron en la cabeza: siteFocusScore, cuánto se centra un site en un tema, y siteRadius, cuánto se alejan sus páginas de ese tema central.
Hace poco me tocó analizar un SaaS B2B que quería posicionar un producto nuevo y no había manera. Tenía páginas y enlaces internos, y el producto apenas asomaba en Google. Lo usé de excusa para replicar esas dos métricas con un modelo de embeddings que corre en un portátil, sin GPU ni APIs de pago.
En este post va todo: qué guarda Google, qué patentes y papers hay detrás, cómo lo calculé paso a paso, el código, lo que salió y sus límites. No te va a dar el número de Google, pero sirve como proxy para visualizar la relevancia de tu site. Los datos del ejemplo están anonimizados. Los productos se llaman A, B, C y “el producto nuevo”, y los competidores, 1, 2 y 3.
¿Qué es la relevancia de un site?
Cuando hablamos de relevancia casi siempre pensamos en la página: si responde a la búsqueda, si tiene las entidades que tocan, si el title encaja. Eso sigue ahí. Pero Google también mira el site entero. Lo dice en su guía de sistemas de ranking, y lo anunció en 2022 con el helpful content update:
Site-wide signals and classifiers are also used and contribute to our understanding of pages.
This update introduces a new site-wide signal that we consider among many other signals for ranking web pages.
Ese sistema ya no funciona por separado: desde marzo de 2024 forma parte de los sistemas principales de ranking, y la guía lo lista entre los retirados. La idea de señales a nivel de site sigue en la guía actual, que es la primera cita.
Aquella entrada de 2022 traía una lista de preguntas para autoevaluarse, como “Does your site have a primary purpose or focus?”, y otra de señales de alarma, entre ellas “Are you producing lots of content on different topics in hopes that some of it might perform well in search results?”. La documentación actual mantiene las dos (ahora dice “many different topics”).
Ojo con leer eso como “un site, un tema”. Danny Sullivan lo aclaró poco después, y John Mueller tiró de la misma idea al revisar una web que había perdido tráfico e indexación:
You absolutely can have multiple topics within one blog.
One of the things I noticed is that there's a lot of totally unrelated content on the site. Is that by design?
Varios temas caben en un site. Sullivan lo explicó en el mensaje siguiente: lo que cuenta es la parte de “in hopes that some of it might perform well”, abrir temas para ver si alguno pega.
Para este post, la relevancia de un site es cuánto encaja cada página con aquello de lo que va el site. Y eso se puede medir con vectores.
¿Qué guarda Google?
En el leak de la Content Warehouse API de mayo de 2024 hay un módulo dedicado a esto, QualityAuthorityTopicEmbeddingsVersionedItem:
| Campo | Descripción en el leak |
|---|---|
pageEmbedding | Sin descripción |
siteEmbedding | “Compressed site/page embeddings.” |
siteFocusScore | “Number denoting how much a site is focused on one topic.” |
siteRadius | “The measure of how far page_embeddings deviate from the site_embedding.” |
versionId | Sin descripción |
O sea: un vector por página, un vector por site, un número para el foco y otro para lo lejos que quedan las páginas del centro.
El módulo no está aislado. Aparece dentro de CompressedQualitySignals, el paquete de señales comprimidas que Google guarda con cada documento, en el campo topicEmbeddingsVersionedData: “Versioned TopicEmbeddings data to be populated later into superroot / used directly in scorers”. Los usan directamente los sistemas que puntúan (scorers) o pasan más tarde a superroot, la capa que reordena y monta los resultados.
La documentación de ese paquete dice dónde vive: en Mustang, el sistema principal de ranking, y en TeraGoogle, el índice secundario. En TeraGoogle va con los datos de cada documento, “which means it can be used in preliminary scoring”, la primera criba de candidatos, y en una memoria que la propia documentación describe como “very limited”. Los embeddings comparten paquete con siteAuthority, la autoridad del site, y babyPandaV2Demotion, una penalización que se aplica encima de Panda.
Mi lectura: Google no gasta memoria escasa en algo que no usa. Estos embeddings van pegados a cada URL, junto a señales de ranking conocidas, y están disponibles cuando Google puntúa.
Hay otro módulo que encaja, QualityNsrNsrData, con las señales de calidad a nivel de site (NSR). Tres cosas de ahí tienen que ver con este post:
- Otro vector por site.
site2vecEmbedding: “Site2vec embeddings”. Su versión comprimida es “to be used in superroot since the full embeddings take too much space”. - Qué es un site para Google.
siteChunk: “Primary NSR sitechunk”. Casi siempre coincide con el host de la URL canónica, pero “in rare, but important cases” se calcula a partir del marcado de la página, y hay unsecondarySiteChunkaún más fino. Un site puede ser un trozo de tu dominio. - Cuánto varía la calidad entre páginas.
siteQualityStddeves la dispersión de las notas de calidad (PQ) de las páginas de un site, ychardScoreVariance, la varianza de chard, un “site quality predictor based on content”.
Esto último me parece importante: además de la media, Google guarda cuánto se dispersan las páginas de un site. En tema, con siteRadius. En calidad, con estos dos campos.
Mike King lo leyó así en su análisis del leak: Google estaría “comparing the page embeddings to the site embeddings to see how off-topic the page is”.
El leak es un esquema de datos. No dice cómo se calculan esos campos ni cuánto pesan, y Google pidió, por boca de Davis Thompson, no sacar conclusiones “based on out-of-context, outdated, or incomplete information”. Todo lo que viene a partir de aquí replica la idea con herramientas públicas. El valor que calcula Google no lo podemos ver desde fuera.
¿Qué dicen las patentes?
Antes de ir una a una, este es el mapa: 25 años de papers, patentes y documentación de Google sobre la relevancia a nivel de site.
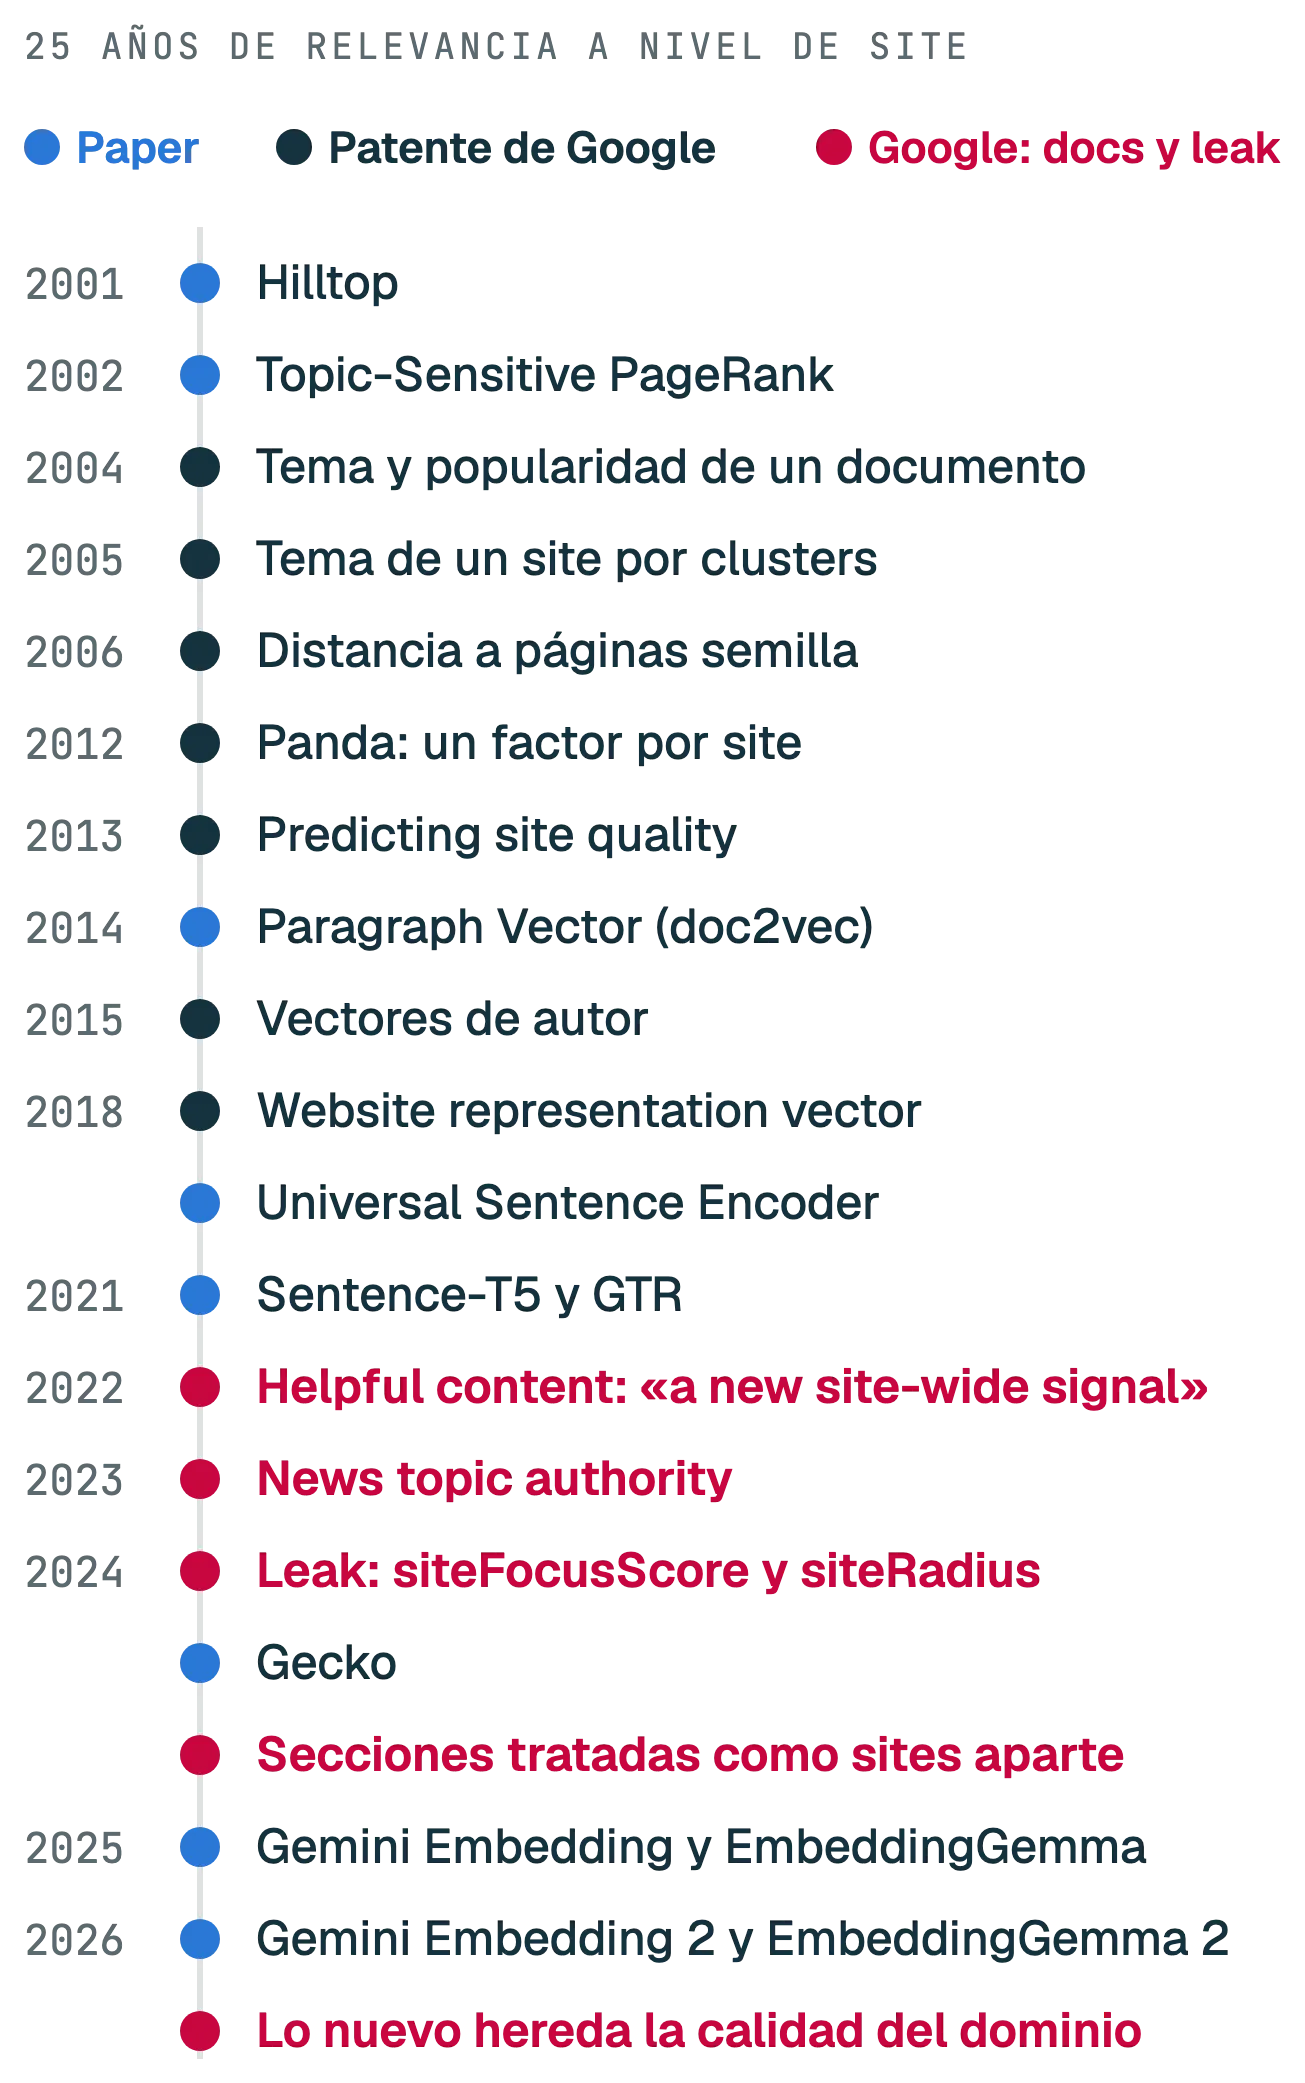
La más cercana es Website representation vector, solicitada en 2018 y abandonada en Estados Unidos. Describe una red neuronal que convierte el contenido de un site (texto, imágenes y enlaces) en un vector. Luego agrupa sites por “a quality score representing a quality measure of the website relative to other websites”, combina los vectores de cada grupo “by averaging, multiplying, summing, or dividing” y clasifica un site nuevo según lo cerca que queda de cada grupo. Lo hace por áreas de conocimiento, y los ejemplos de grupos son sites escritos por expertos (médicos), aprendices (estudiantes de medicina) y profanos. Bill Slawski la analizó en 2020, antes del leak.
Ojo: esa patente agrupa sites por calidad. La mecánica, en cambio, es la misma que vamos a usar: vectores de contenido, una media como centro y distancias a ese centro.
La idea de sacar el tema de un site agrupando su contenido es mucho más vieja. En 2005 Google solicitó una patente (concedida en 2012 y ya caducada) para categorizar un website a partir de clusters de su contenido: calcula “a set of scored clusters (e.g., semantic, term co-occurrence, etc.) for the Website” y los mapea a una taxonomía.
Luego están las de Panda, que ya repasé en el post de quality. Aquí me quedo con otra de Navneet Panda con el mismo título, Ranking search results: agrupa los resultados por dominio y aplica “a group-based modification factor” a cada resultado del grupo. Es la forma más clara de decir que una nota del site cambia cómo rankea cada página. Las otras dos, Site quality score y Predicting site quality, calculan esa nota a partir de las búsquedas que se refieren al site (navegacionales o de marca) frente a las que acaban en un clic en él, o a partir del lenguaje del site.
Hay una versión con enlaces de la misma idea. La patente de distancias en el grafo de enlaces, de Nissan Hajaj, “computes shortest distances from the set of seed pages to each page” y rankea con esas distancias. Cambia el espacio (enlaces en lugar de texto), pero sigue midiendo lo lejos que estás de un centro. Por eso, más abajo, también calculo el centro del site ponderado por PageRank interno.
Y una curiosa: Generating author vectors, de Brian Strope y Quoc Le, entrena un vector por autor a partir de lo que escribe y permite agruparlos. Quoc Le es coautor de Paragraph Vector, el paper que popularizó los vectores de documento, y Strope firmó el Universal Sentence Encoder. Los nombres que firman las patentes de vectores son los mismos que firman los papers.
Cuidado con dos patentes que se citan mucho para esto y no dicen lo que se les atribuye. Ranking search results based on entity metrics no tiene ninguna métrica de autoridad a nivel de site. Y Determining topic authority puntúa autores dentro de una colección de documentos, sin hablar de webs ni de resultados de búsqueda. Y, como siempre, que algo esté patentado no quiere decir que esté en uso.
¿Y los papers?
La relevancia temática de un site tiene raíces en dos papers de principios de los 2000. Hilltop (2001), de Krishna Bharat, que acabó en Google, rankea a través de páginas “expertas” en un tema. Topic-Sensitive PageRank (2002), de Taher Haveliwala, calcula “a set of PageRank vectors, biased using a set of representative topics”. Los dos mezclan tema y autoridad.
La parte de vectores tiene una línea clara dentro de Google:
| Año | Paper | Qué aporta |
|---|---|---|
| 2014 | Paragraph Vector (Le y Mikolov) | Un vector de tamaño fijo por documento entero |
| 2018 | Universal Sentence Encoder | Embeddings generales de frases y textos cortos |
| 2021 | Sentence-T5 y GTR | Embeddings basados en T5 y retrieval con dos encoders |
| 2024 | Gecko | Embeddings compactos destilados de un LLM |
| 2025 | Gemini Embedding | El primer modelo de embeddings basado en Gemini |
| 2025 | EmbeddingGemma | Un modelo pequeño y abierto que puedes correr en local |
| 2026 | Gemini Embedding 2 | El modelo actual de Google, multimodal: texto, imagen, vídeo, audio y documentos en el mismo espacio |
| 2026 | EmbeddingGemma 2 | La versión abierta y multimodal, que también corre en local |
Fuera de Google, Homepage2Vec (EPFL, 2022) ya hacía un vector por website para clasificar su tema en 92 idiomas. Y un benchmark de 2025 que compara formas de construir vectores de website encontró que lo que más pesa es el texto, y que un TF-IDF con una red pequeña compite bien. Para medir esto no hace falta el modelo más grande.
Yo usé multilingual-e5-small, de Microsoft (paper de E5 y versión multilingüe). Tiene 384 dimensiones, cubre unos 100 idiomas y corre en CPU. La ficha del modelo dice tres cosas que importan para este cálculo:
- Corta a 512 tokens. Si le pasas una página entera, solo lee el principio. Por eso troceo cada página.
- Hay que poner el prefijo
query:cuando usas los vectores para clustering o como features. - Los cosenos se concentran entre 0,7 y 1,0. Las distancias salen diminutas (0,03) y solo se pueden comparar entre sites procesados con el mismo modelo y el mismo preprocesado.
Y una advertencia general: un paper de Netflix, Is Cosine-Similarity of Embeddings Really About Similarity?, demuestra que en algunos embeddings el coseno puede dar similitudes “arbitrary and therefore meaningless”. Con modelos entrenados para similitud, como E5, funciona, pero conviene saberlo antes de tratar el número como una verdad.
¿Cómo se calcula?
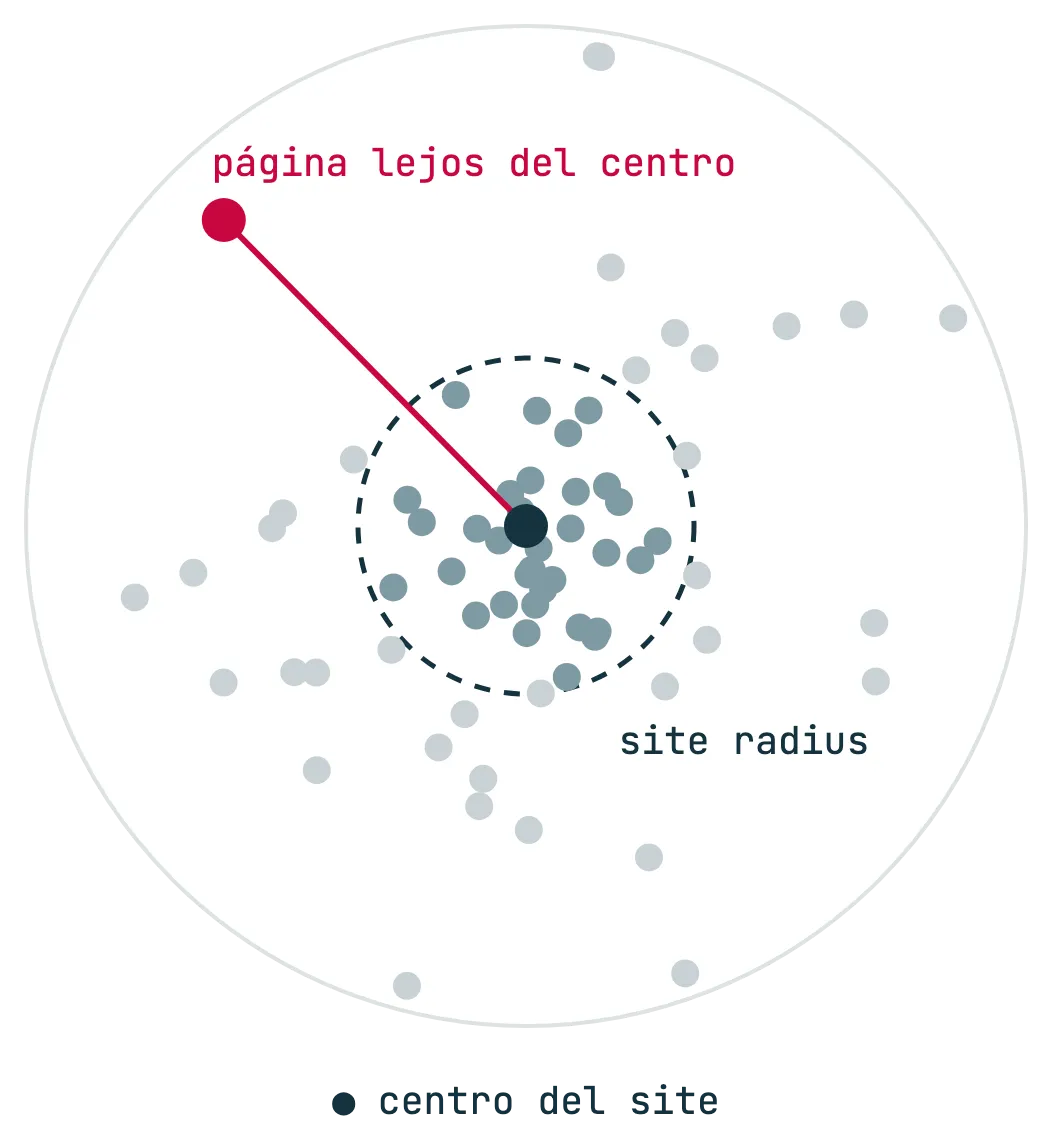
La mecánica cabe en cinco líneas:
- Vector de página: la media de los vectores de sus trozos de texto.
- Centro del site: la media de los vectores de página, normalizada.
- Distancia: 1 menos el coseno entre la página y el centro.
- Site radius: la distancia media de las páginas.
- Fuera del radio: una página que está más lejos que esa media.
Así lo hice paso a paso.
1. Rastrear y quedarte con el texto que importa
Rastreé las páginas indexables que devuelven 200 y son su propia canónica, y saqué el texto de los encabezados, párrafos, listas y tablas. Hay que quitar todo lo que se repite en cada página: menú, footer, banners. Si no, todas las páginas se parecen porque comparten el mismo footer.
Mi regla: un bloque de texto que aparece en más del 30% de las páginas es boilerplate y se va. Ojo: si un page type tiene más del 30% de tus URLs, su texto de plantilla también se va. Para conservarlo, sube el umbral por encima del peso de tu page type más grande o cuenta la frecuencia dentro de cada page type. En el ejemplo, esa regla quitó 119 bloques.
# rows: las páginas rastreadas; blocks_of(row): sus bloques de texto
counts = defaultdict(int)
for row in rows:
    for block in set(blocks_of(row)):
        counts[block] += 1
boilerplate = {block for block, c in counts.items() if c / len(rows) > 0.3}
2. Un vector por página
Corto cada página en trozos de 180 palabras y me quedo con los 8 primeros, unas 1.440 palabras. Las dos cifras son decisiones de optimización. El crawl ya me daba las palabras de cada página, con la mediana en 1.016, así que con 8 trozos la mayoría entra entera, y el corte evita que las muy largas, como una de 18.000 palabras, disparen el tiempo de cálculo. Y aunque el modelo admite hasta 512 tokens, lo limito a 256, donde caben los trozos de 180 palabras, porque así va más rápido. Con estos dos ajustes el cálculo corre en un portátil normal, sin GPU: no hace falta un ordenador potente para hacerlo con tu web. Calculo el vector de cada trozo, hago la media y la normalizo. Ese es el vector de la página.
model = SentenceTransformer('intfloat/multilingual-e5-small', device='cpu')
model.max_seq_length = 256
# pieces: los trozos de todas las páginas; owner: a qué página pertenece cada trozo
chunk_vectors = model.encode(['query: ' + piece for piece in pieces], normalize_embeddings=True)
owner = np.array(owner)
vectors = np.stack([chunk_vectors[owner == i].mean(0) for i in range(n_pages)])
vectors /= np.linalg.norm(vectors, axis=1, keepdims=True)
En el ejemplo, 2.035 páginas en inglés dieron 12.636 trozos.
Las traducciones no las proceso. Cada traducción hereda el vector de su original en inglés a través del hreflang. Tiene una ventaja: el modelo es multilingüe, pero aun así coloca el mismo texto en dos idiomas en puntos algo distintos, y eso metería ruido de idioma. Y tiene un coste que conviene tener claro: así el radio no puede ver si una traducción es mala.
3. El centro del site y la distancia de cada página
w = weights / weights.sum()
mean = (vectors * w[:, None]).sum(0)
focus = np.linalg.norm(mean)       # 1 si todas las páginas apuntan igual
site = mean / focus                # el centro del site
distance = 1 - vectors @ site      # 1 - coseno con el centro
radius = (distance * w).sum()      # distancia media: el radio
outside = distance > radius
Como las distancias absolutas no se pueden comparar entre modelos, convierto cada distancia a percentil según su orden, de 0 (la página más cercana al centro) a 1 (la más lejana). En las tablas lo muestro de 0 a 100. Y por cada page type miro dos cosas, el porcentaje de páginas fuera del radio y su percentil mediano.
4. Decidir cuánto pesa cada página
El centro depende de cómo ponderes las páginas, y esa decisión cambia mucho el resultado. Probé tres versiones sobre las más de 14.000 URLs del site contando las traducciones:
| Percentil mediano | Cada URL igual | Por PageRank interno | Por tráfico estimado |
|---|---|---|---|
| Producto B | 9 | 17 | 28 |
| Producto C | 27 | 56 | 12 |
| Producto A | 39 | 23 | 47 |
| Herramientas gratis | 62 | 59 | 64 |
| Producto nuevo | 80 | 21 | 83 |
| Blog | 85 | 67 | 87 |
| Site radius | 0,0286 | 0,0321 | 0,0128 |
Cada versión sirve para leer una cosa distinta. Si cada URL pesa igual, mandan los page types con muchas páginas casi iguales. Ponderando por tráfico, el producto C se lleva el 78% del peso y arrastra el centro hacia él. Ponderando por PageRank interno, el producto nuevo salta del percentil 80 al 21, porque sus páginas reciben el 11% del PageRank interno.
Juntas, la de cada URL igual y la de PageRank interno cuentan lo que le pasa al producto nuevo. El enlazado interno le pasa autoridad, y aun así, cuando cada URL pesa igual, su contenido queda lejos del centro. Le llegan los enlaces; lo que falla es la relevancia de sus páginas, y eso encaja con que apenas asome en Google. Lo vemos con más detalle en el ejemplo.
¿Cuál usa Google? No se sabe. Para el diagnóstico me quedo con “cada URL igual”: el leak no habla de pesos, y es como calculan el centro herramientas como Screaming Frog. Las otras dos las uso para entender qué tira del centro.
5. Ponerle nombre a los temas
Para saber de qué va el centro, construí un vector por tema con las 60 keywords con más volumen de cada producto y miré a qué tema se parece cada página. Hace diez años, en el sector, esto se hacía con TF-IDF y keywords LSI, un enfoque que hoy está bastante desfasado: el TF-IDF cuenta palabras y los embeddings comparan significados.
Aquí se ve la compresión de E5 de la que hablaba antes. Los vectores de los cinco temas se parecen entre sí entre 0,90 y 0,94 de coseno, aunque son productos distintos. Con estos modelos, todo lo que habla de un sector parecido queda cerca. Por eso trabajo con percentiles.
6. Dibujarlo sin mentir
Un mapa en 2D de vectores de 384 dimensiones siempre deforma algo. PCA o t-SNE deforman justo lo que quiero enseñar, la distancia al centro. Así que separé las dos cosas:
- El orden de distancias es real. Cada página se coloca a su percentil de distancia al centro: se ve qué páginas están más lejos, aunque no cuánto.
- El ángulo solo agrupa. Proyecto lo que separa a cada página del centro sobre el plano que mejor separa los temas: las dos primeras componentes de los centros de cada categoría.
cats = np.array(cats)
categories = np.unique(cats)
# lo que aleja a cada página del centro
offsets = vectors - np.outer(vectors @ site, site)
# el plano que mejor separa los centros de cada categoría
means = np.stack([offsets[cats == c].mean(0) for c in categories])
_, _, vt = np.linalg.svd(means - means.mean(0), full_matrices=False)
xy = offsets @ vt[:2].T
# la dirección solo sirve para agrupar; el radio del mapa es el percentil de distancia
angle = np.arctan2(xy[:, 1], xy[:, 0])
Si quieres pasarlo por tu web, te mando el script con los pasos 2 a 4 ya montados (el 1, quitar menú y footer, lo haces al preparar el CSV): le das un CSV y te devuelve la tabla por page type.
Lo que no esperaba: focus y radius dicen lo mismo
Al terminar me salieron estos dos valores con las 2.035 páginas en inglés: radius = 0,0306 y focus = 0,9694 (contando las traducciones, 0,0286 y 0,9714). Suman 1, y hay una razón matemática.
Si los vectores de página están normalizados, el coseno medio de las páginas con el centro es igual a la longitud de la media de los vectores:
páginas: vectores unitarios x1 … xn
media:   m = (x1 + … + xn) / n
centro:  c = m / |m|
coseno medio con el centro = (x1·c + … + xn·c) / n = m·c = |m|
radio = 1 − coseno medio = 1 − |m| = 1 − focus
En estadística direccional, |m| tiene nombre: es la longitud de la resultante media, y 1 − |m| es la generalización a más dimensiones de la varianza circular. Con pesos pasa lo mismo.
Las implementaciones con código público que he revisado definen las dos métricas igual. El Space de DEJAN calcula site_focus_score = max(0, 1 - site_radius), y Taha Yelkenci también define el foco como 1 menos la distancia media.
Pero Google guarda siteFocusScore y siteRadius en campos separados. Si uno se dedujera del otro, guardar los dos sería redundante, y más en una memoria que la propia documentación describe como “very limited”. Así que su radius, o su focus, es otra cosa. Algunas opciones, todas especulación mía:
- Un radio que mide dispersión: la desviación típica de las distancias o un percentil alto, como el 90.
- Un focus que sale de agrupar las páginas: qué parte del site cae en el tema principal.
- Un cálculo por trozo de site: por
siteChunk, en vez de por dominio entero.
En la práctica, lo útil de la réplica es el reparto: qué páginas quedan lejos y de qué page types son. Por eso, para cada page type, reporto:
- El porcentaje de páginas fuera del radio.
- El percentil mediano de sus páginas.
Y para el site entero, el percentil 90 de distancia (0,0481 en el ejemplo) y la desviación típica (0,0132), por si Google mide dispersión.
El ejemplo: un SaaS con un producto nuevo que Google no encuentra
El site es un SaaS B2B con tres productos maduros (A, B y C), una colección de herramientas gratis, un blog y un producto nuevo que es la apuesta de la empresa. Tiene unas 2.000 páginas únicas en inglés, traducidas en parte a otros 15 idiomas: más de 14.000 URLs en total.
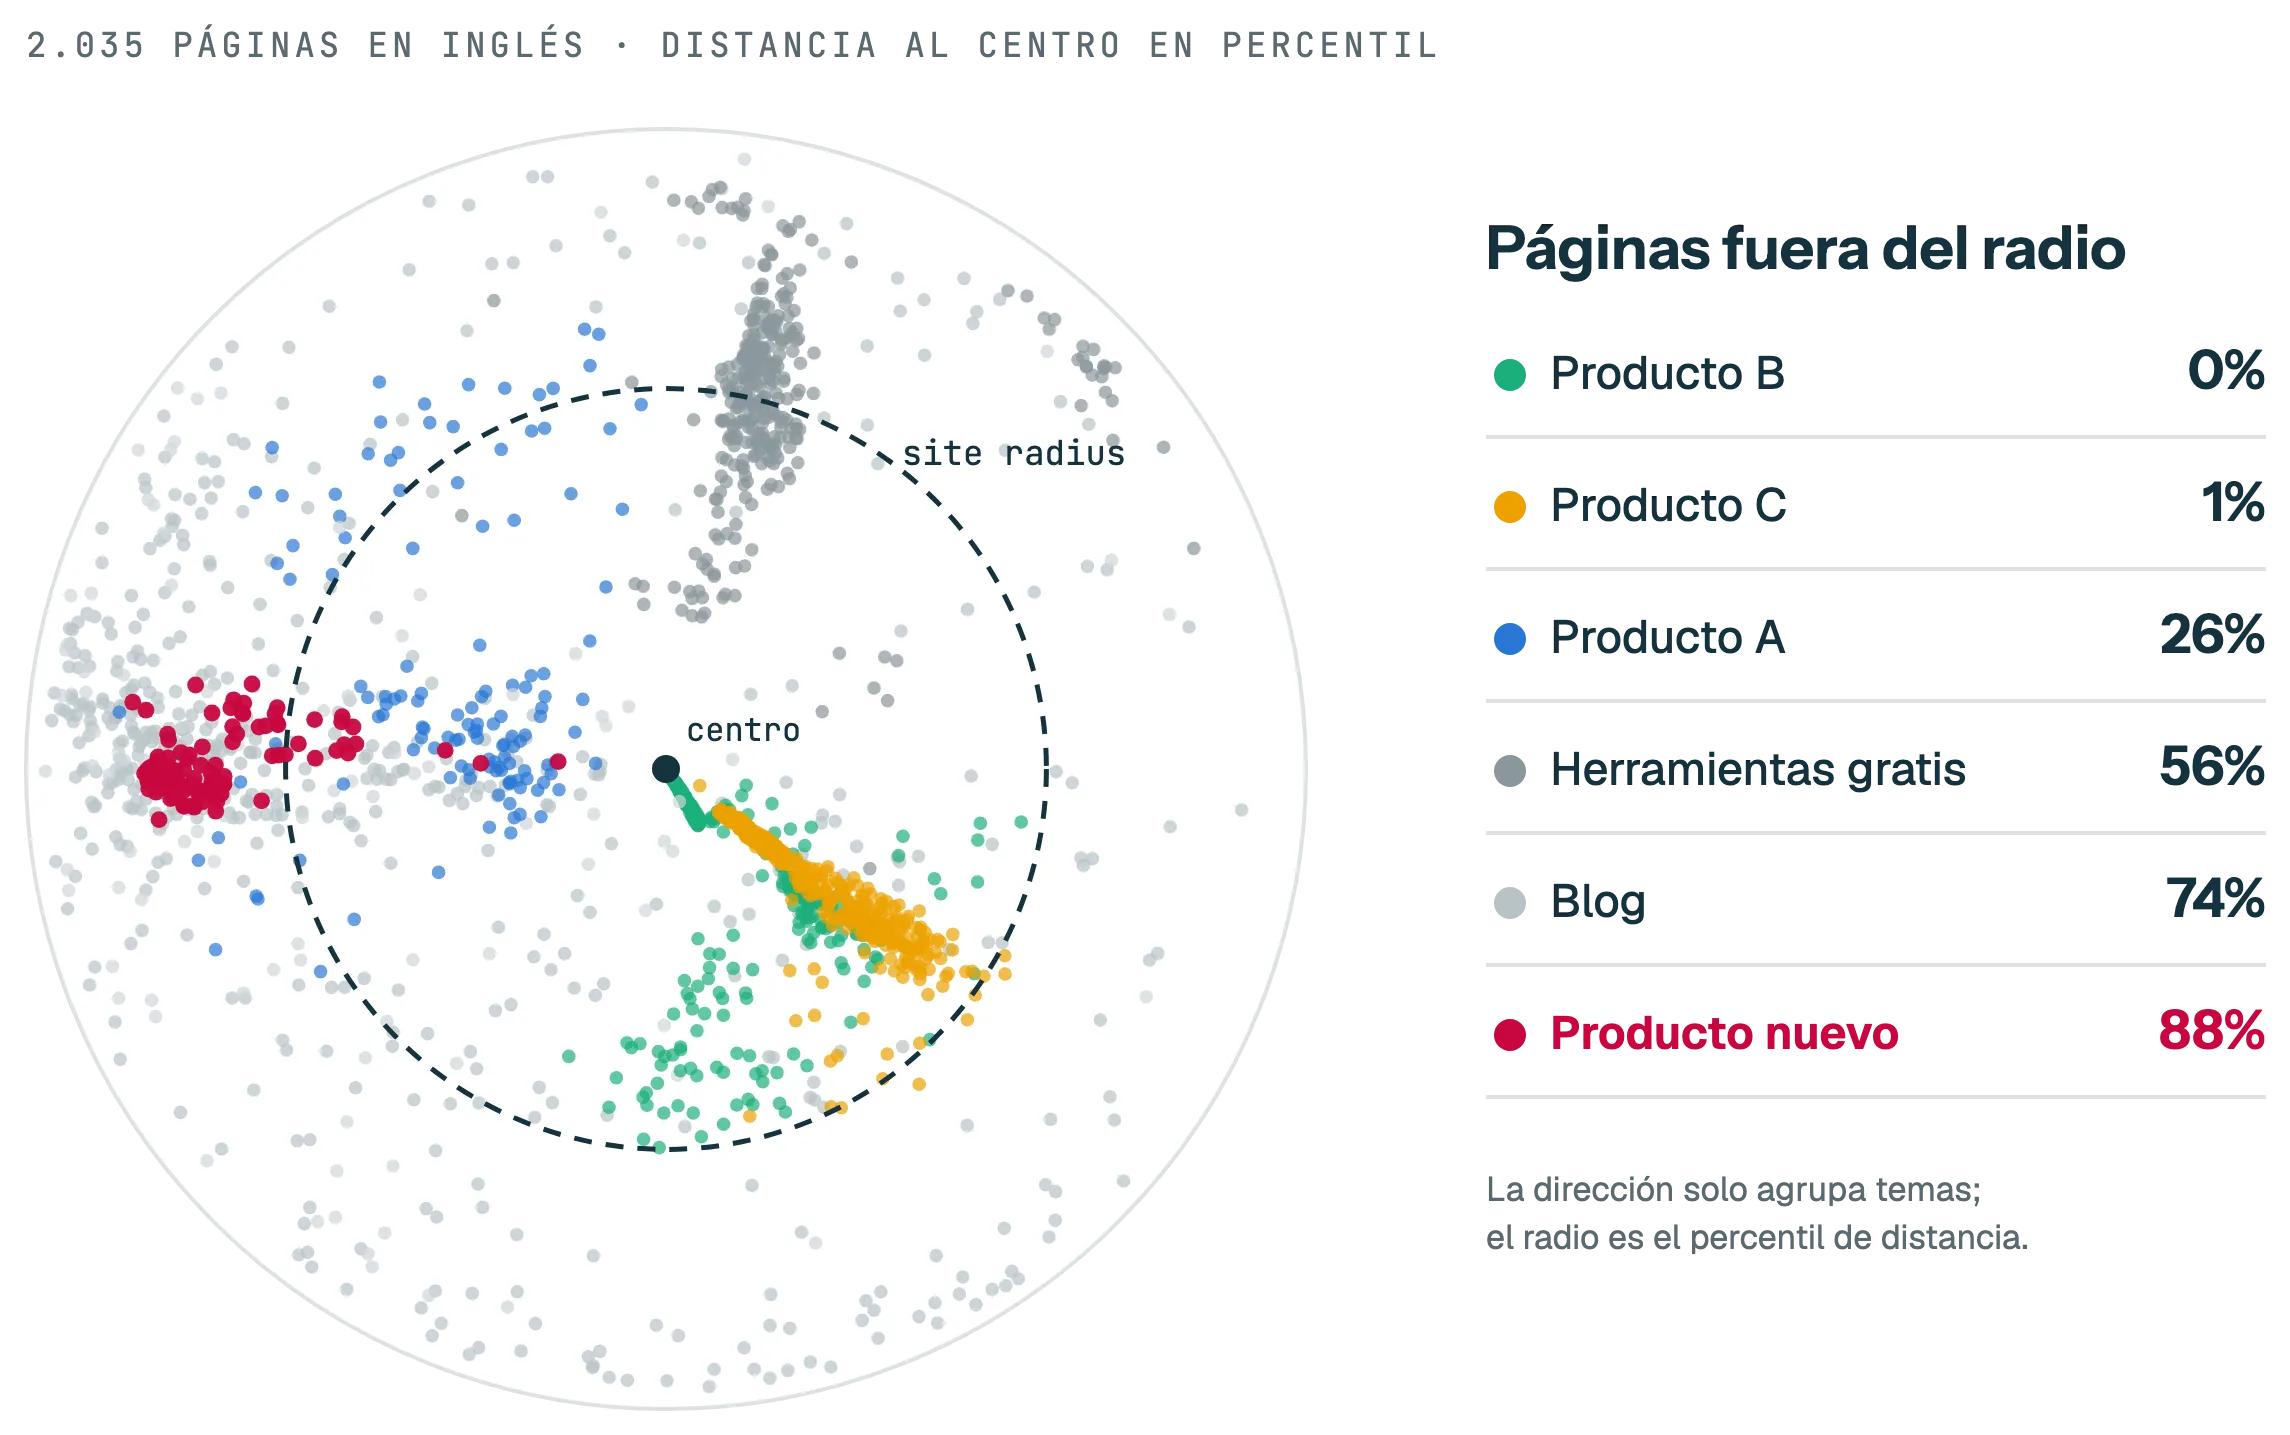
| Page type | Páginas en inglés | Fuera del radio | Percentil mediano |
|---|---|---|---|
| Producto B | 385 | 0% | 10 |
| Producto C | 441 | 1% | 27 |
| Producto A | 133 | 26% | 36 |
| Herramientas gratis | 324 | 56% | 63 |
| Blog | 543 | 74% | 80 |
| Producto nuevo | 111 | 88% | 76 |
| Otras páginas | 98 | 69% | 85 |
Lo que se ve:
El centro del site son plantillas. Los productos B y C tienen cientos de páginas generadas con una misma plantilla, una por cada combinación de opciones. Son casi iguales entre sí y llenan el centro. El centro del site está donde se amontonan sus plantillas (el 41% de las URLs en inglés), y aquí eso no coincide con lo que la empresa quiere vender.
El producto nuevo vive en el borde. El 88% de sus páginas queda fuera del radio, y su página principal está más lejos que el 80% del site.
Las únicas páginas del producto nuevo que entran son puentes. De 111, solo 13 quedan dentro del radio, y las más cercanas al centro son casos de uso que comparten vocabulario con el producto A. Ese tipo de página es la que acerca un tema nuevo al centro de un site.
Los enlaces no explican el problema. Con el centro ponderado por PageRank interno, el producto nuevo concentra el 11% del PageRank del site, y solo el 8% de ese PageRank queda fuera del radio. El site enlaza su producto nuevo. Lo que le falta es contenido que hable de lo mismo que el resto del site.
El radio no lo explica todo. Las herramientas gratis están un 56% fuera y aun así son la segunda categoría del site en tráfico estimado (el 15%), solo por detrás del producto C. La autoridad y la intención de búsqueda pesan, y el radio no las ve.
Para saber si un 88% es mucho, pasé el mismo cálculo por tres competidores. Como solo tenía el texto completo del site analizado, en los cuatro usé titles, meta descriptions y encabezados H1 a H3, con hasta 800 páginas por competidor. En los cuatro sites marqué como páginas del producto nuevo las que lo mencionan en la URL o en el title, con la misma regla. Por eso el site analizado sale con un 81% fuera y no con el 88%: cambian el texto (solo encabezados), las traducciones y qué páginas cuentan como del producto nuevo.
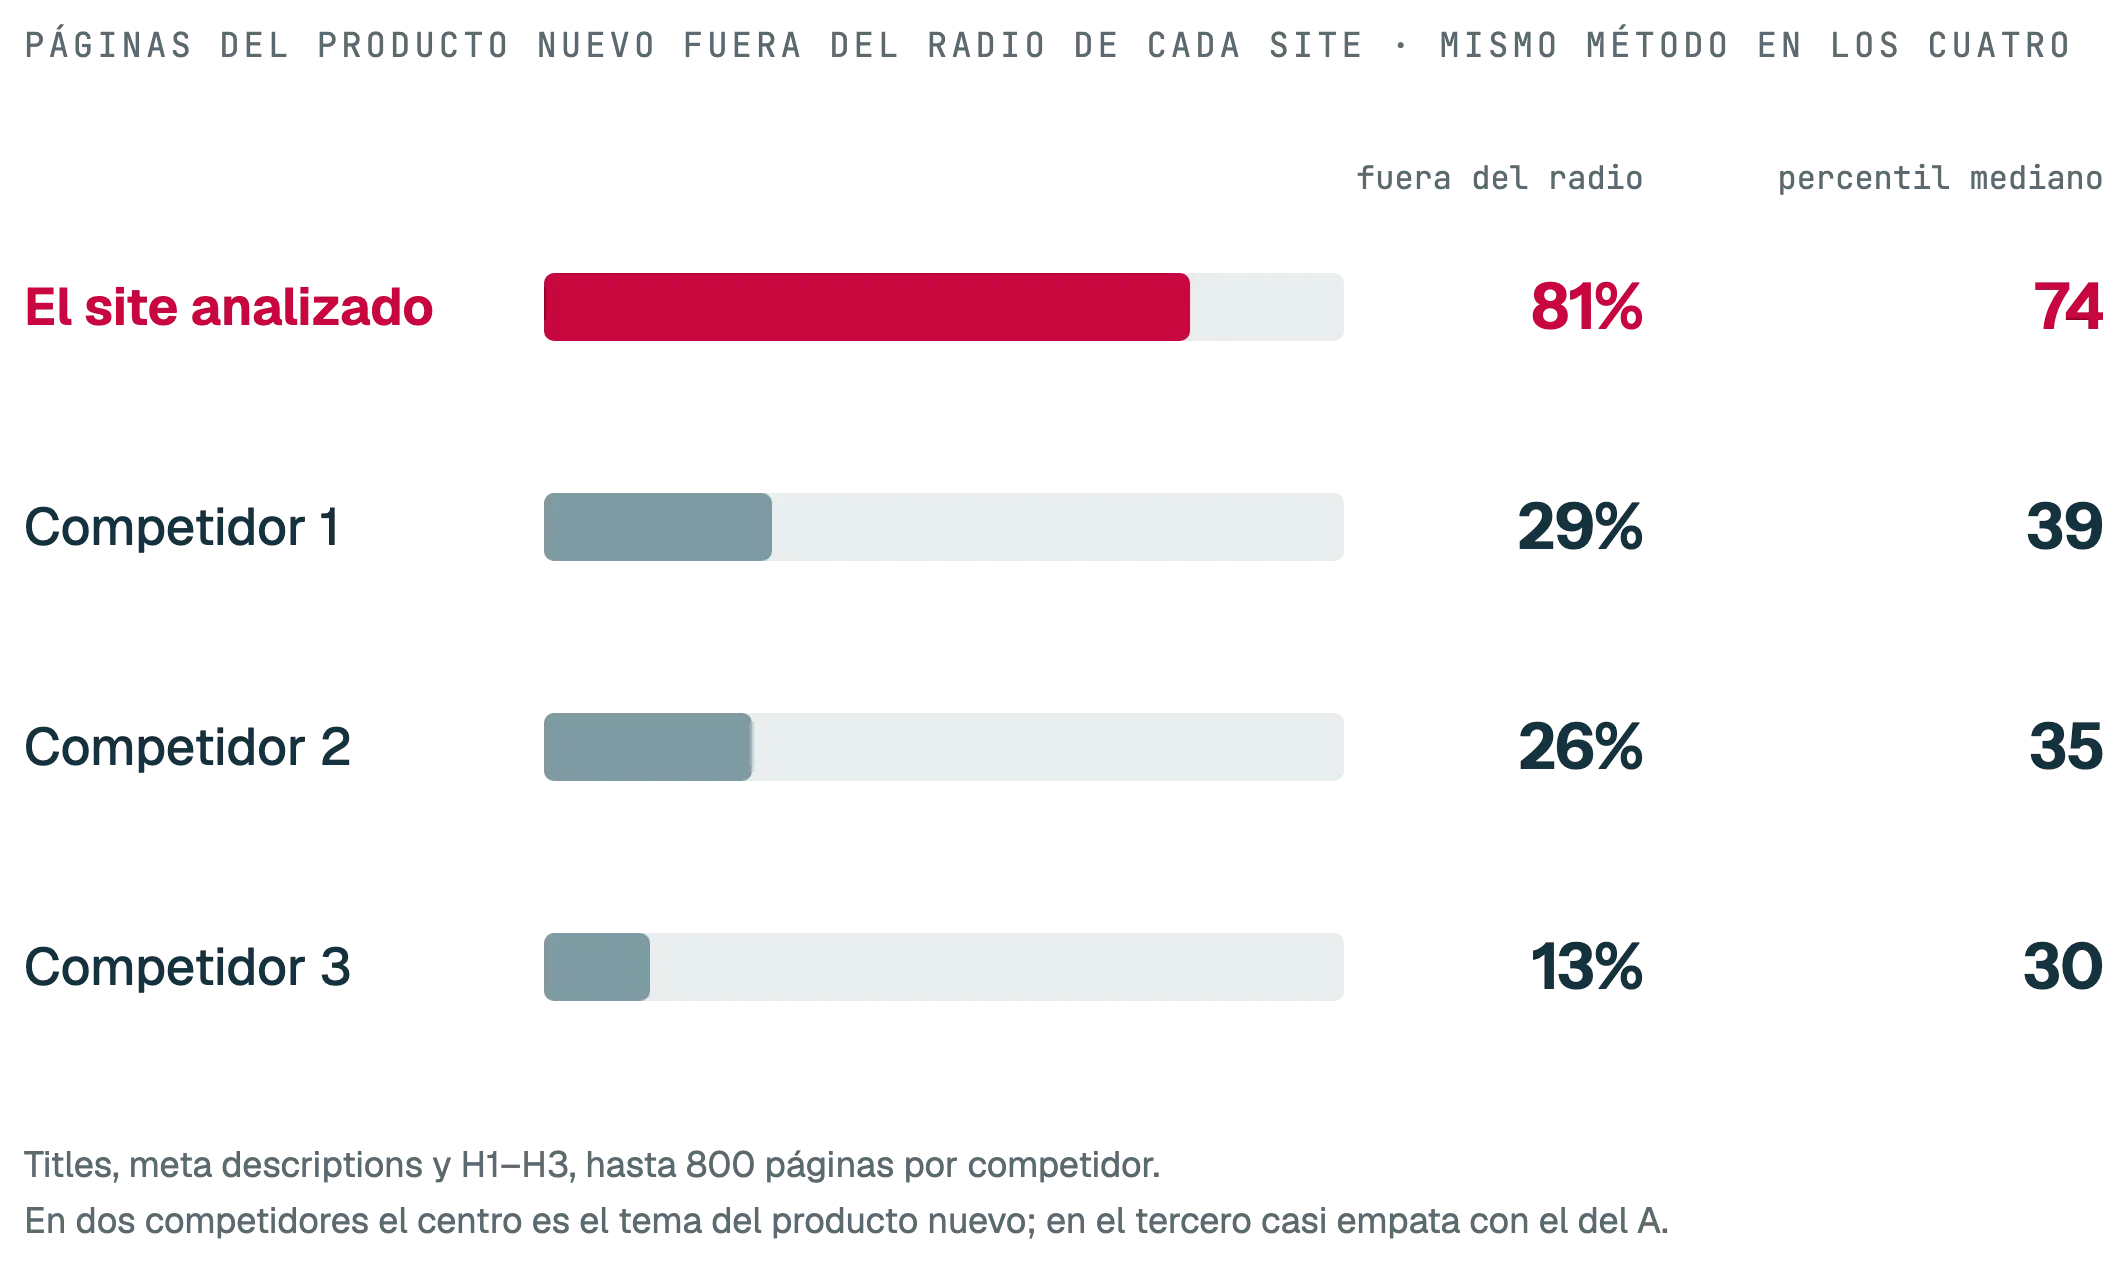
En dos de los tres competidores, el centro del site es claramente el tema del producto nuevo; en el tercero, casi empata con el del producto A. En los tres, entre el 13% y el 29% de esas páginas queda fuera del radio. En el site analizado es al revés: el producto nuevo es la periferia.
¿Cuántas páginas hacen falta para ganar relevancia?
Cuando un producto no posiciona, el diagnóstico habitual es “te falta relevancia”, seguido de un keyword research y una lista de contenidos. Con los embeddings se puede concretar mucho más: qué page types publicar, cómo tienen que hablar y, sobre todo, cuántas páginas hacen falta para mover el centro del site.
El proceso tiene tres piezas:
- Un keyword research del producto. Yo lo hago con unas skills propias que compartiré más adelante.
- Los page types con los que rankean los competidores para esas keywords: comparativas, integraciones, casos de uso, plantillas.
- Los embeddings, para medir dónde caerían esas páginas respecto al centro de tu site y simular cuántas hacen falta para que el producto nuevo entre en el radio.
En el ejemplo, la simulación la hice con lo que ya había: dando más peso a las páginas actuales del producto nuevo, como si tuviera entre 50 y 1.000 páginas más como las que ya tiene, y recalculando el centro y el radio en cada caso. Lo hice sobre las 2.035 páginas en inglés, cada una contada una vez. Si cuentas cada traducción como una URL, lo que manda es el total de URLs nuevas: hacen falta unas 3.000 para que el producto nuevo baje del 85% al 38%. Son, por ejemplo, las mismas 300 páginas traducidas a unos 10 idiomas.
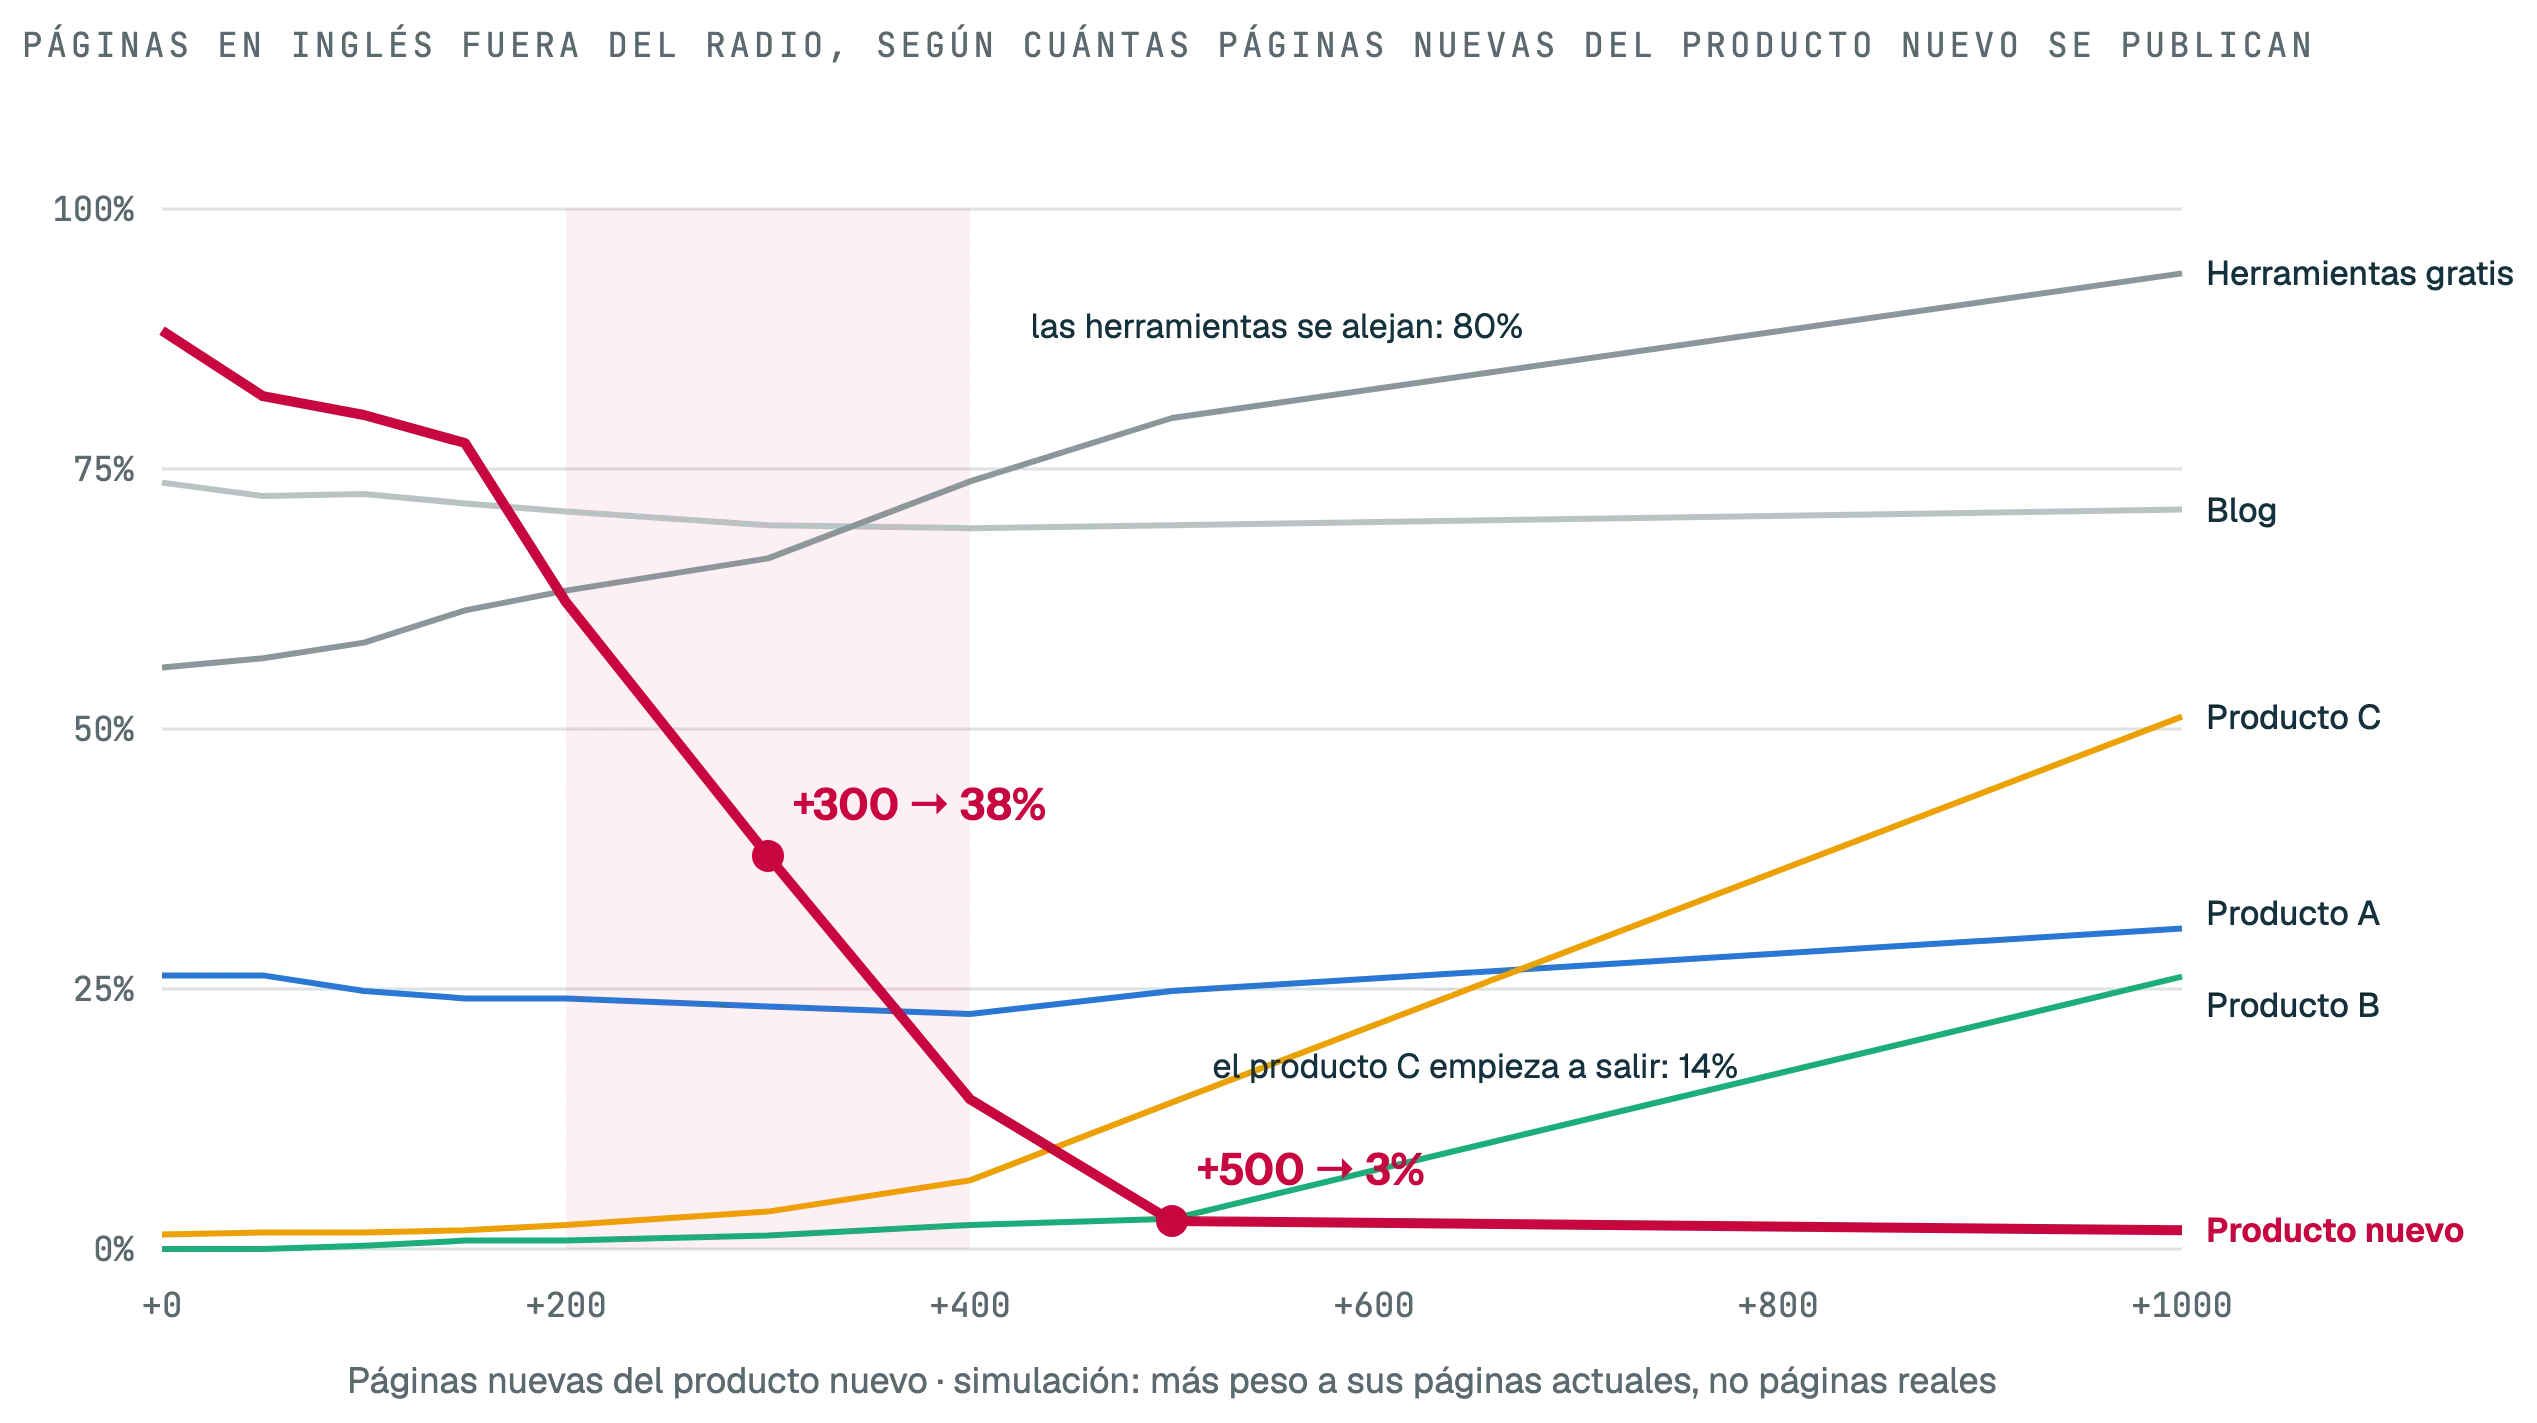
| Páginas nuevas en inglés | Producto nuevo fuera | Herramientas fuera | Producto C fuera |
|---|---|---|---|
| 0 | 88% | 56% | 1% |
| +200 | 62% | 63% | 2% |
| +300 | 38% | 66% | 4% |
| +400 | 14% | 74% | 7% |
| +500 | 3% | 80% | 14% |
| +1.000 | 2% | 94% | 51% |
Con este modelo, a partir de unas 300 páginas nuevas en inglés la mayoría de las páginas del producto nuevo queda dentro del radio. Y hay dos cosas más. La primera, que la curva no baja poco a poco. Entre 200 y 400 páginas, el producto nuevo pasa del 62% al 14%: es el punto en el que el centro del site cambia de sitio.
La segunda me parece la más útil del ejercicio. El centro se mueve hacia lo que publicas, y lo que estaba cerca del centro anterior se aleja. Con 500 páginas, las herramientas gratis pasan del 56% al 80% fuera y el producto C empieza a salir. Es el mismo mecanismo que hunde a una web cuando abre una sección lejos de su foco, visto desde el otro lado. Publicar mucho de algo nuevo también deja fuera lo que ya tenías.
Las limitaciones importan:
- La simulación es circular. Modela las páginas nuevas como copias de las actuales del producto nuevo, y dos de cada tres son plantillas por idioma casi idénticas entre sí. Las páginas reales (plantillas, comparativas, casos de uso) caerán en otro sitio.
- La forma correcta es modelar las páginas que vas a publicar. Usa como modelo las páginas de los competidores que rankean para tus keywords o, mejor, un piloto de 20 páginas tuyas: calcula sus vectores, mira dónde caen y repite la simulación con el peso de las 300 que piensas publicar.
- El salto entre 200 y 400 es un precipicio. Pequeños cambios en el número de páginas mueven mucho el porcentaje. Para un objetivo trimestral es un número traicionero.
¿Cuáles son sus límites?
Lo que calculas así no es el siteRadius de Google. Es un proxy para visualizar la relevancia de un site: qué páginas y qué page types se alejan del tema que marca el resto. Para eso funciona, siempre que tengas claros sus límites:
- El modelo no es el de Google. No sabemos qué modelo usa Google ni con qué texto de cada página lo alimenta, y, como vimos, al menos uno de sus dos números mide otra cosa. El valor absoluto no se va a parecer al suyo. Lo que se puede leer es el orden: qué queda más cerca del centro y qué más lejos.
- Cambia con cada decisión. El modelo, el texto que entra (la regla del 30%), cuántos trozos usas por página y cómo pesas las páginas mueven el centro. En el ejemplo, el producto nuevo pasa del percentil 80 al 21 solo con cambiar el peso. Por eso trabajo con percentiles y solo comparo resultados sacados con el mismo método.
- El centro lo marca el volumen. La media se va hacia lo que más páginas tiene. En el ejemplo, hacia las páginas de plantilla casi iguales entre sí. Fuera del radio quiere decir lejos de lo que más publicas, que no tiene por qué ser lo que vendes.
- Hay cosas que no ve. Las traducciones heredan el vector del original, así que una mala traducción no se nota. Y la distancia dice de qué habla una página, pero no si es buena.
- Es una correlación. Que el producto nuevo quede lejos del centro encaja con que no posicione, pero no lo demuestra.
¿Qué hago con esto?
Lo uso para diagnosticar y para decidir antes de publicar. Así:
- Calcúlalo por page type. Es la misma lógica que uso en una auditoría SEO: el número del site sirve de poco. El porcentaje fuera del radio y el percentil de cada page type te dicen qué partes del site están lejos de lo que el site es.
- Simula antes de abrir una sección. Si vas a lanzar un page type nuevo, mide dónde cae y qué empuja hacia fuera.
- Si una sección queda lejos, tienes tres salidas. Añadir puentes entre lo que ya eres y lo nuevo, consolidar las páginas flojas o separar la sección en su propio subdominio o dominio, como hicimos con los idiomas en Softonic. Si la sección son idiomas, mira también cómo está montado tu SEO internacional.
- No lo pongas como KPI. Fusionar 50 páginas casi idénticas mueve el porcentaje sin ganar nada, y el precipicio de la simulación hace que un objetivo tipo “menos del 40% fuera” dependa de una docena de páginas.
- Compara competidores solo con el mismo método. Mismo modelo, mismo prefijo, mismo troceado y mismo tipo de texto. Si no, comparas preprocesados.
Lo que me hace pensar que esto importa es una frase de Google sobre site reputation abuse, de noviembre de 2024:
Aside from site reputation abuse issues, we also have systems and methods designed to understand if a section of a site is independent or starkly different from the main content of the site. By treating these areas as if they are standalone sites, it better ensures a level playing field, so that sub-sections of sites don't get a ranking boost just because of the reputation of the main site.
Fíjate en el principio: “aside from site reputation abuse issues”. La entrada va de contenido de terceros alojado en webs con reputación, pero esta parte habla de algo general. Google detecta secciones muy distintas del contenido principal y las mide como si fueran sites aparte. Y sigue: esas secciones pueden notar cambios de tráfico si “no longer benefit from site-wide signals”, lo que no significa que estén penalizadas: “It means we’re measuring them independently, even if they are located within a site”.
En agosto de 2026 Google actualizó esa política, que ahora llama site reputation policy, y su documentación lo dice de forma más directa. Google presume que “individual pages (including new pages) match the overall quality of other pages on the domain”, y cuando separa una parte del site, “over time, our ranking systems learn to rank these parts of a site independently”. Ahí habla de calidad y de secciones con contenido de terceros que separa tras una revisión manual. Aun así, confirma dos cosas que importan aquí: por defecto una página hereda las señales de su dominio, y una sección que Google separa las va perdiendo con el tiempo.
Que el radio del leak forme parte de esos sistemas es una deducción mía. Pero si una sección tuya queda muy lejos del centro, lo prudente es asumir que puede no heredar lo bueno del resto del site.
¿Quién más lo ha calculado?
No soy el primero, y cada uno lo ha hecho de una forma:
- Screaming Frog, desde la versión 22, marca “Low Relevance Content” con el mismo método: promedia los embeddings de todas las páginas rastreadas para sacar un centroide y mide la distancia de cada página. Por defecto usa un umbral de 0,4 y saca los vectores de OpenAI, Gemini u Ollama. En el anuncio de la versión 22 lo relacionan con el leak: medir cuánto se desvían los embeddings de página del embedding del site “was hinted at within the Google leak”.
- DEJAN tiene un Space en Hugging Face, ahora pausado (el código se puede leer), con el modelo LaBSE. Usa los slugs de las URLs del sitemap en lugar del texto de las páginas.
- Patrick Stox tiene un Semantic Site Map con all-MiniLM-L6-v2 sobre el texto de los artículos y temas por k-means esférico, con un radio por tema. Avisa de que las distancias “only have meaning within this site’s included corpus”.
- Taha Yelkenci lo calcula con TF-IDF en vez de embeddings, y también lo deja claro: su radio no dice nada sobre el
siteRadiusde Google. - Eric Gilley, en iPullRank, lo usó para podar un blog de más de 1.000 posts: centroides por tema a partir de keywords, más un vector con la descripción del negocio, combinados con clics de Search Console y antigüedad. Marcaron cerca del 45% de los posts y quitaron o redirigieron más de 500.
- Go Fish Digital ofrece una auditoría semántica que dice partir del leak y mide un “Focus Score” y un “Site Radius”. No publica cómo los calcula.
- Gus Pelogia explicó en el blog de Screaming Frog cómo sacar embeddings de un rastreo y calcular similitudes entre páginas, que es el punto de partida de todo esto.
Lo que añade este post: trocear el texto de cada página y promediar los trozos (DEJAN usa solo el slug de la URL), las traducciones resueltas con hreflang, la comparación entre pesos, la simulación y lo que implica que focus y radius salgan iguales.
El script
Los fragmentos de cada paso los tienes arriba. El script completo, el que lee el CSV (con los pesos que tú le pases), trocea el texto, calcula distancias y percentiles y saca el resumen por page type, te lo mando por email junto con un README y un CSV de ejemplo.
Necesita un CSV con dos columnas obligatorias, url y text, y dos opcionales: group (el page type, el producto o lo que quieras comparar) y weight (PageRank interno, tráfico o lo que quieras usar como peso). Acepta CSV separado por comas, punto y coma o tabuladores, en UTF-8. Ojo con los pesos: si ponderas por tráfico, unas pocas URLs marcan el centro y casi todo el site queda fuera del radio. Úsalo para ver qué tira del centro, no para leer el porcentaje fuera.
Para sacar el texto vale cualquier crawler. Lo importante es dejar fuera menú, footer y banners: configura la extracción para que coja solo el contenido principal, o aplica la regla del 30% del paso 1.
Corre en CPU, sin GPU ni claves de API. La primera vez descarga el modelo, unos cientos de MB. Si quieres probar otro, pásalo con --model y, si su ficha pide un prefijo, añádelo con --prefix.
Con las 2.035 páginas del ejemplo, con los grupos ya anonimizados, la salida es esta. Son las mismas cifras de la tabla del ejemplo (páginas en inglés, cada URL igual):
2035 páginas · site radius 0.0306 · focus 0.9694
percentil 90 de distancia 0.0481 · desviación típica 0.0132
grupo                páginas   fuera  percentil
producto-b               385      0%       0.10
producto-c               441      1%       0.27
producto-a               133     26%       0.36
herramientas             324     56%       0.63
producto-nuevo           111     88%       0.76
blog                     543     74%       0.80
otras                     98     69%       0.85
El CSV de salida tiene una fila por página, ordenada de la más cercana al centro a la más lejana, con su distancia, su percentil y si queda fuera del radio. Ábrelo y empieza por el final: ahí están las páginas que menos encajan con tu site.
Referencias
- Google Content Warehouse API: QualityAuthorityTopicEmbeddingsVersionedItem . HexDocs
- Google Content Warehouse API: CompressedQualitySignals . HexDocs
- Google Content Warehouse API: QualityNsrNsrData . HexDocs
- Mike King. Secrets from the Algorithm: Google Search’s Internal Engineering Documentation Has Leaked . iPullRank (2024-05-28)
- Mia Sato. Google confirms the leaked Search documents are real . The Verge (2024-05-29)
- A guide to Google Search ranking systems . Google Search Central
- Chris Nelson. What creators should know about Google's August 2022 helpful content update . Google Search Central (2022-08-18)
- Creating helpful, reliable, people-first content . Google Search Central
- Chris Nelson. Updating our site reputation abuse policy . Google Search Central (2024-11-19)
- Update to the Site Reputation Policy . Google Search Central (2026-08-28)
- Spam policies for Google web search: site reputation policy . Google Search Central (2026-08-28)
- Jen Granito. Understanding news topic authority . Google Search Central (2023-05-23)
- Danny Sullivan. Danny Sullivan sobre varios temas en un mismo blog . Mastodon (2022-12-11)
- Danny Sullivan. Danny Sullivan sobre la frase de los temas en la entrada de 2022 . Mastodon (2022-12-11)
- John Mueller. John Mueller sobre contenido no relacionado en un site . Bluesky (2025-06-10)
- Yevgen Tsykynovskyy. US20200050707A1: Website representation vector . Google Patents (2020-02-13)
- Bill Slawski. Google Using Website Representation Vectors to Classify with Expertise and Authority . Go Fish Digital (archivo de SEO by the Sea) (2020-02-21)
- David Gehrking, Ching Law, Andrew Maxwell. US8229957B2: Categorizing objects, such as documents and/or clusters, with respect to a taxonomy . Google Patents (2012-07-24)
- Navneet Panda, Vladimir Ofitserov, Kaihua Zhu. US9684697B1: Ranking search results . Google Patents (2017-06-20)
- April R. Lehman, Navneet Panda. US9031929B1: Site quality score . Google Patents (2015-05-12)
- Navneet Panda, Yun Zhou. US9767157B2: Predicting site quality . Google Patents (2017-09-19)
- Nissan Hajaj. US9165040B1: Producing a ranking for pages using distances in a web-link graph . Google Patents (2015-10-20)
- Brian Patrick Strope, Quoc V. Le. US9984062B1: Generating author vectors . Google Patents (2018-05-29)
- Amit Singhal, Urs Hölzle. US8595225B1: Systems and methods for correlating document topicality and popularity . Google Patents (2013-11-26)
- US10235423B2: Ranking search results based on entity metrics . Google Patents (2019-03-19)
- Michael J. Procopio. US8458196B1: System and method for determining topic authority . Google Patents (2013-06-04)
- Krishna Bharat, George A. Mihaila. When Experts Agree: Using Non-Affiliated Experts to Rank Popular Topics (Hilltop) . WWW10 (2001)
- Taher H. Haveliwala. Topic-Sensitive PageRank . WWW 2002 (2002)
- Quoc V. Le, Tomas Mikolov. Distributed Representations of Sentences and Documents . Google (arXiv) (2014)
- Daniel Cer et al.. Universal Sentence Encoder . Google (arXiv) (2018)
- Jianmo Ni et al.. Sentence-T5: Scalable Sentence Encoders from Pre-trained Text-to-Text Models . Google (arXiv) (2021)
- Jianmo Ni et al.. Large Dual Encoders Are Generalizable Retrievers . Google (arXiv) (2021)
- Jinhyuk Lee et al.. Gecko: Versatile Text Embeddings Distilled from Large Language Models . Google DeepMind (arXiv) (2024)
- Jinhyuk Lee et al.. Gemini Embedding: Generalizable Embeddings from Gemini . Google (arXiv) (2025)
- Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini . Google (arXiv) (2026)
- EmbeddingGemma 2: Unified and Efficient Multimodal Representations . Google (arXiv) (2026)
- H. Schechter Vera et al.. EmbeddingGemma: Powerful and Lightweight Text Representations . Google (arXiv) (2025)
- Liang Wang et al.. Text Embeddings by Weakly-Supervised Contrastive Pre-training . Microsoft (arXiv) (2022)
- Liang Wang et al.. Multilingual E5 Text Embeddings: A Technical Report . Microsoft (arXiv) (2024)
- intfloat/multilingual-e5-small . Hugging Face
- Sylvain Lugeon, Tiziano Piccardi, Robert West. Homepage2Vec: Language-Agnostic Website Embedding and Classification . EPFL (arXiv) (2022)
- J. Gerber, J. Saxer, B. Kreiner, A. Weiler. Benchmarking state of the art website embedding methods for effective processing and analysis in the public sector . Journal of Intelligent Information Systems (2025)
- Harald Steck, Chaitanya Ekanadham, Nathan Kallus. Is Cosine-Similarity of Embeddings Really About Similarity? . Netflix (arXiv) (2024)
- Directional statistics . Wikipedia
- Dan Sharp. Screaming Frog SEO Spider Update – Version 22.0 . Screaming Frog (2025-06-10)
- How to Identify Semantically Similar Pages & Outliers . Screaming Frog
- siteFocusScore (Hugging Face Space) . DEJAN
- Patrick Stox. Semantic Site Map
- Taha Yelkenci. How to Audit Your Site Against the Google Leak Signals (2026-10-15)
- Eric Gilley. Relevance Engineering at Scale: Smarter Content Pruning with Embeddings & SEO . iPullRank (2025-05-14)
- Semantic Content Audit . Go Fish Digital
- Gus Pelogia. Using the Screaming Frog SEO Spider and OpenAI Embeddings to Map Related Pages at Scale . Screaming Frog (2024-09-23)